scGPT是个很重要的工具,应用了大预言模型实现对scRNA数据的利用。本质上和scBERT还是一个样子,也是预训练-微调的大模型。后续可以让他做很多工作,比如细胞身份注释、多批次整合、多组学整合、扰乱响应、基因网络推理等等。(这里的基因网络推理和细胞身份注释是我们非常需要的)
首先我们还是先看作者:王波,多伦多大学教授,计算机系的博士,主攻机器学习和计算生物学。
然后就是介绍:
单细胞测序存在多模态的数据图谱,对新的研究问题产生了很大的挑战。应对这一挑战的一个很有前途的方法是生成预先训练基础模型,然后进行微调。transformer是很厉害的一个架构,并且被用于很多模型,比如DALL-E2和GPT-4这些模型,还有Encoder这类模型也常被用在生物领域。而这些模型在不同任务上进行训练,训练集数据的广度和规模都受到限制,所以需要一个基础模型能够理解各种不同的数据完成各种任务。
其实本质上还是一个transformer为主要架构的大模型,用了3300w个细胞进行训练,使其可以在不同任务上也能完成预测任务。本文主要通过三个方面来说明生成式基础模型:1.可以在跨下游任务的情况下进行高效学习;2. 通过比较训练后的模型的参数和预训练的参数,基因嵌入,注意力权重等参数可以为不同条件下基因之间的互作关系提供支持;3. 观察到了拓展效应,更大的训练集的输入可以产生更好的预训练模型。
1.单细胞transformer基础研究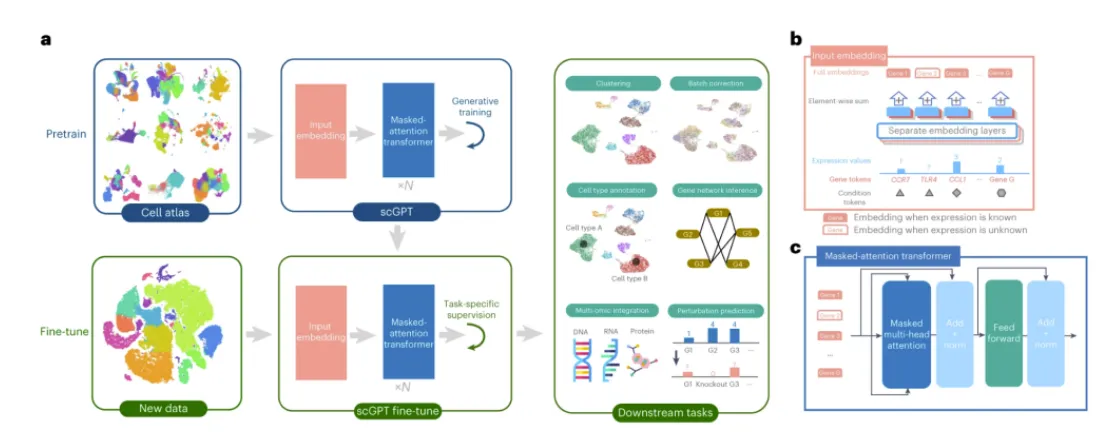
scGPT核心模型主要是包含:多头注意力机制的堆叠transformer,产生基因与细胞的嵌入。预训练阶段引入注意力掩码和生成训练管道,自监督的方式实现训练。这样的话基因的顺序并不重要,可以根据细胞和其他基因表达量生成基因表达结果。可以用这个实现对各种基本任务的研究。因为这个研究是覆盖了人类51个器官和组织,综合了400多项研究,表明在处理生物变异的方面上具有卓越的能力。
2.scGPT提高了注释的精度
为了微调预训练的模型用于细胞身份注释,神经网络分类器把transformer的细胞嵌入输出当作输入,预测细胞类型。在多个训练集上进行测试,和TOSICA和scBERT进行了比较,实现了准确度、精度、召回度的更加优秀的方法。
3.预测无法观测的遗传扰动
利用自注意力机制可以分析受扰动基因表达和其他基因反应的复杂作用,预测难以观测的基因扰动和反应。训练了这个模型用于三个数据集,包含单基因扰动和双基因扰动,并对扰动产生的基因进一步表达量变化进行预测。当然scGPT是最好的模型。然后接下来,因为实验能做的毕竟是有限的,所以如果可以用计算机来模拟其他扰动会对扰动研究产生很大的好处。实验中只覆盖了236次,而实际上可能的扰动有5565次,实验验证的只占5%,用scGPT实现对所有扰动的测试,然后对结果进行聚类,发现发生在相同功能组上的扰动被聚集在一起了,所以这个扰动预测还是很有用的。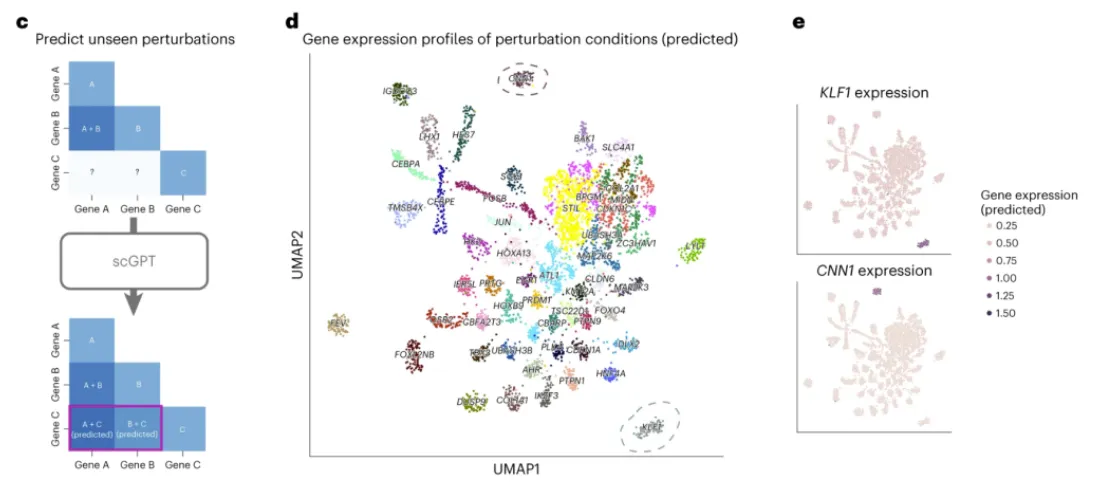
随后进行计算机反向预测,根据结果的细胞状态给出遗传扰动的源头。这种功能可以实现靶基因的确定,然后根据表达量的改变实现对基因的确定,推动发现潜在治疗靶点。之后用了一个数据库的子集,使用39个扰动,然后进行测试寻找扰动来源,当然是能成功找到对应的扰动来源。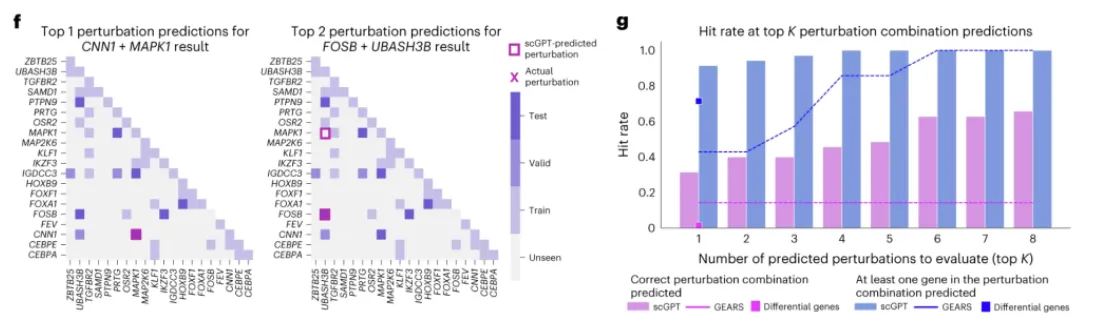
- 实现多批次和多组学的集成
整合来自多个批次的scRNA-seq数据,如何消除其批次效应并保留生物学内部的方差是很重要的。通过恢复遮蔽基因的方式实现了对scGPT的微调,将其与scVI、Seurat、Harmony这三个模型进行比较。即使没有微调在这个数据集上有很强的效果,对多批次有很好的效果。
单细胞多组学整合,可以包含不同的组学数据,表现出优秀的细胞类型聚类性能。比其他的都好,而且还是唯一一个分类出CD8幼细胞的模型。
- 揭示特定的细胞状态的基因网络(GRN)
现在的GRN推理方法依赖于静态的基因表达相关性或者是通过伪时间估计作为因果图的代表。其实这么来说,也就是通过寻找相关性来判断,而不是直接去找因果关系。scGPT为这种基因建模进行了优化,在基因嵌入和注意力图中隐藏了这种关系。基因嵌入可以构建“相似性网络”,表征基因间的相关关系;而注意力机制可以捕捉不同细胞状态下的基因功能网络。因此可以使用这个流程实现GRN的流程,仅仅通过预训练就可以实现对基因网络的构建,当然微调后效果会更好。可以通过学习到的基因嵌入,把相关功能的基因放在一起,区分不同功能的基因。主要的过程是:先找到有联系的基因然后判断是共表达还是因果关系。后面用了几个例子实现了这个功能。然后还用共表达的实验来验证了结果。除了使用基因嵌入进行GRN推理外,还可以用注意力机制捕获基因之间的互作关系,提供了单个细胞上下文特异性基因调控相互作用的深入了解,可能因细胞类型不同和细胞状态不同改变。
6.迁移学习的缩放和上下文效应
这里首先解释一下迁移学习是什么:迁移学习是一种不需要从头学习的训练方式,需要对预训练的模型进行迁移,可以借助已经学到的模式对其他相似任务进行微调。在这里主要考虑了两个要素,一个是预训练数据量,一个是特定的上下文对训练的影响。
对训练数据的评估很简单,就用了3w到3300w之间不等的测序数据进行预训练,看到随着预训练数据增加,对微调模型的性能就更好,所以说明存在拓展效应,更大的预训练数据集会导致更好的预训练嵌入,下游任务性能也提高。第二个是特定上下文的影响,上下文说的是在特定的细胞类型上进行预训练,然后对相似类型细胞进行微调。如果是有特定的训练集,那么进行对应是能够实现更好的效果的。
因为这里完全没有提到是怎么架构的所以我们展示一下GPT的架构: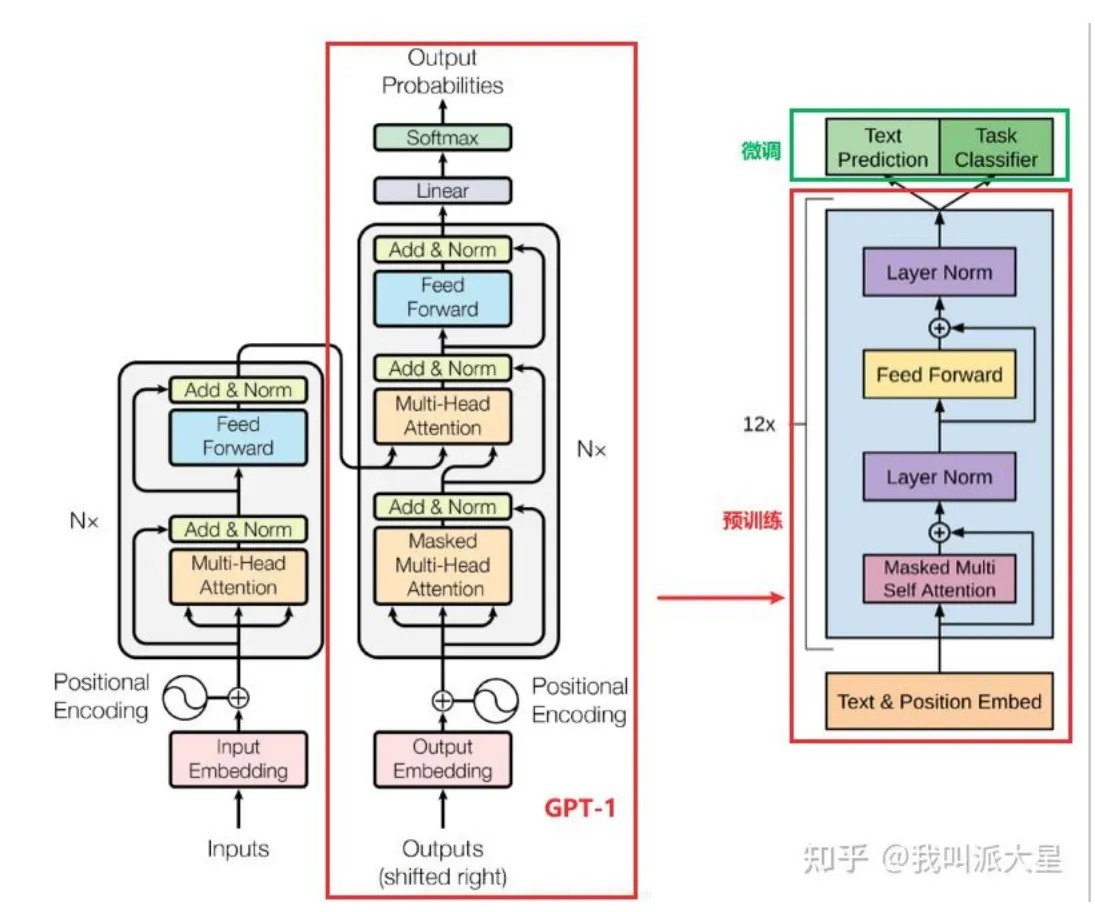
transformer作为很重要的一个架构,是GPT的基石。GPT-本质上就是transformer的decoder部分,1用了12个decoder,2用了12-48层,3用了96层作为预训练的模型。
每层都是由几个关键子层组成的:1.遮蔽多头注意力机制,只能看前面的词而不能看后面的词,这是transformer的encoder自身带有的东西。用于模拟人类自然语言阅读,从上到下,不能看到后面的东西。多头主要是用于观察不同的特征,具有不同的注意力模式,捕捉不同的关系。2.层归一化,在每个子层输入前后都会有一层,稳定训练并加速收敛。3.前馈神经网络:通过两层全连接神经网络,增加非线性能力;4.残差连接:每个子层都用残差连接,防止出现梯度消失或梯度爆炸。
输出层包含一个线性层用于将输出转化为词汇表的维度,然后通过softmax转化为一个概率分布成为下一个词。