对细胞命运和AI比较感兴趣,回顾一下2022年发表的一篇文章:scBERT as a large-scale pretrained deep language model for cell type annotation of single-cell RNA-seq data
这篇文章主要针对了单细胞RNA-seq的数据来注释细胞类型的几个痛点,(1)缺少精细的标记基因表; (2)批次效应问题(这种现象在自己做的数据上相对还是可以控制的,但是对于从NCBI等网站上下载数据进行AI训练的情景会表现出非常大的批次效应难以去除); (3)很难利用隐藏的基因间潜在的互作信息。这些都会影响最后训练出来的模型。
作者训练了scBERT这个模型,说是可以解决这些问题。这个模型用了BERT的训练方法,下面简单说一下BERT是怎么训练的。
BERT其实是一种transformer模型,用了多层transformer结构,其实是把多个transformer的encoder堆叠起来形成BERT,图源:https://zhuanlan.zhihu.com/p/403495863 。BERT是一种自监督式训练方式,不需要有label,而是用一种特殊的方式进行训练。比如说在语言方面,可以通过使一个句子的某个单词遮盖住,通过上下文补充这个词(感觉有点像英语考试的选词填空,只是这个选词库极大),这样再与原文对应实现训练。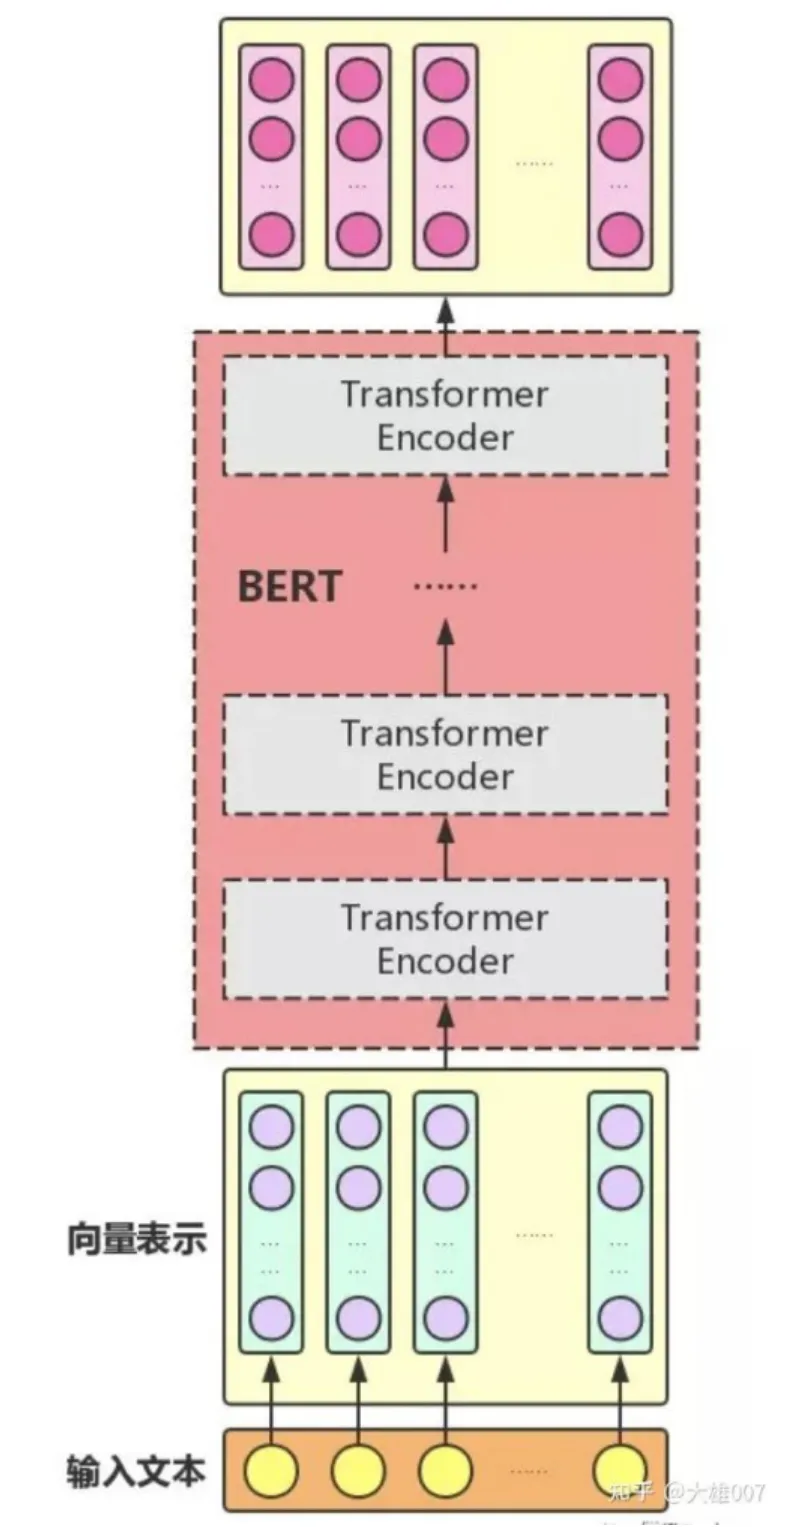
其中先对输入进行embedding,将向量输入encoder堆叠部分,这部分用到了transformer的多头注意力机制,通过残差连接、然后进行层归一化,前馈输入。在BERT的训练过程中需要进行预训练,然后再进行微调(即预训练-微调范式)。这种通过预训练-微调训练出来的模型可以用在很多不同的任务上面。
在本文中,作者通过单细胞RNA-seq的数据进行预训练,训练出了很多接受这些数据的初始化模型,这样就从一个数据集中训练出了一个会“填空”的模型。以上面的文本处理为例子,把每个基因当作一个词,每个细胞的表达谱当作一个句子。这样就可以通过mask其中某个基因,通过其他基因的表达量预测这个基因的表达;或者是通过整体表达谱来区分两个细胞是否是具有相似性以及相似程度有多少(这在自然语言处理中判断两个句子之间的关系也是非常简单的一个任务)。接下来将这个预训练模型转移到特定的scRNA-seq的细胞注释的任务中去(在自然语言中这个任务可以类比为为一个句子判断感情色彩),在这些数据集的作用下进行微调。
整体思路总结到这里,接下来看看文章具体是怎么讲好这个故事的。
现在对于细胞类型的注释有几种类型:(1)使用标记基因注释,即某些特定基因会在某些特定细胞类型中呈现异常的表达值,通过识别这些标记基因的表达量进行注释;(2)使用基于相关性的方法注释,即将待注释的细胞和标准数据集进行相关性分析,看和那个细胞类型最接近;(3)监督分类注释,即使用机器学习的技术训练分类器,用supervised-learning训练一个好的分类器。
这些各自都有局限性:(1)使用标记基因很大程度上依赖于先验知识,而且手动进行注释对操作者要求也很高,同时对于我们想要注释的细胞来说标记基因不一定够用,而且一般细胞类型的变化是多个基因共同影响作用的结果,还有批次效应可能会让基因表达变化量比较大;(2)使用相关性的方法进行注释,老生常谈还是批次效应的问题,即使能够校正批次效应,通过基因表达之间的并不算特别大的相似性也很难下结论说就是某一类细胞,在scRNA-seq数据计算过程中现有的方法不一定能够稳定;(3)使用机器学习训练分类器虽然可以识别,但是这个过程需要高可变基因决定细胞类型,如果不是高可变基因的话,变化量很小的基因很有可能发生误判,而且过程中往往涉及维度变化,在降维的时候就会将某些特征丢弃掉。而且PCA这种降维的方式是求方差的和,这样计算下来那些数量比较多的细胞的方差占比会很大,可能会忽略掉很多稀有的细胞。
那么在这里他们引入了scBERT这个模型,首先来看这个模型是怎么架构的: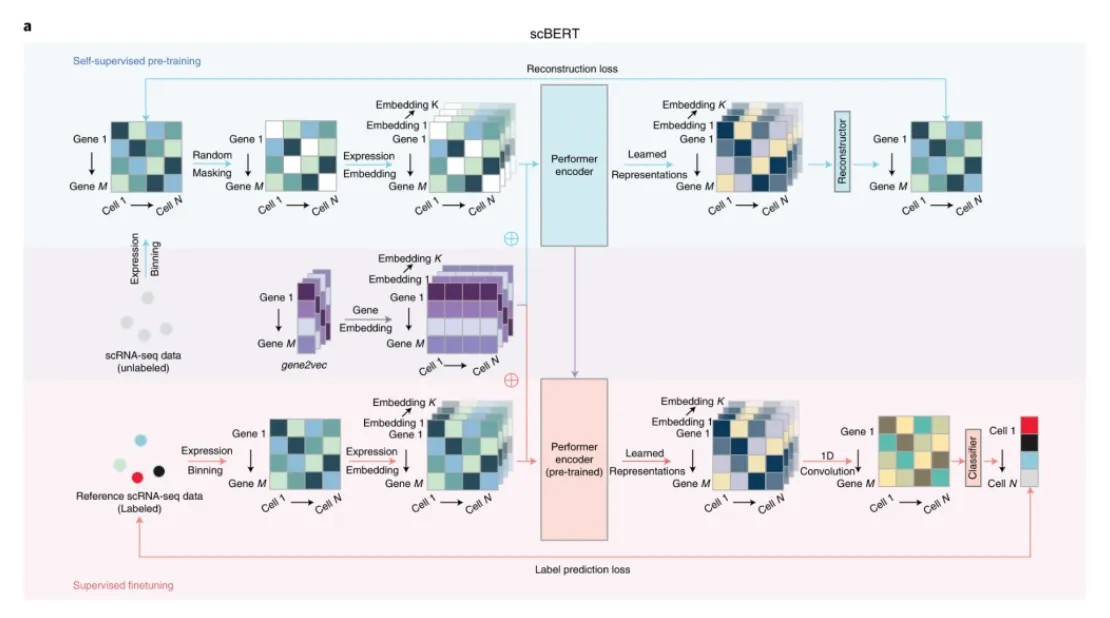
这个架构看起来很吓人,但是我们可以拆开来看。图1a的上半部分是预训练模型,就是强硬的把各个基因的表达量和细胞个数设计成一个矩阵,然后随机的mask掉一些基因表达,将不同的信息embedding成为多个通道(比如NLP任务的位置信息等等)。对于数据处理,因为BERT本身是处理NLP任务的,所以如果让他来处理连续变量是很难的(单词是离散的点,而基因表达量是在数轴上一个连续的分布,在哪个点都有可能),所以他们先对表达量进行分选。分选结束后,对于每个channel都有一个固定值,然后给这些channel不同的权重来共同组成表达量(因为不能直接投喂连续变量),所以这是实现表达量数值的办法。通过这个进行预训练模型,能让他学会不同基因之间表达量的关系。同时加入了基因身份让他能学习到不同基因之间的关系,通过gene2vec来获取,防止不同的基因表达量发生混乱,这个方式文章写在这里:https://bmcgenomics.biomedcentral.com/articles/10.1186/s12864-018-5370-x
在这之后,把这个预训练的模型塞到下半部分,通过三个输入,一是已经训练好的基因表达量和细胞的关系,这个是和预训练模型一起的;二是基因身份,和上面的一样;三是带有label的基因表达矩阵,和1一致,只是带了label方便进行调整。在这之后就开始微调(fine-tuning)这个预训练模型,使其能预测细胞身份。但是在transformer中因为限制了一次只能输入512个词,他们换了performer这个encoder,最多能一次输入16000个基因。
后面就是评估这个模型的性能了:
1.评估细胞类型注释的鲁棒性:用了9个scRNA-seq的数据集,这些数据集包括了17个主要的器官组织、50+种细胞,50w+细胞,对上面提到的三类方法(共11种方法)和scBERT进行比较。当然最终结果肯定是scBERT效果更好。这里用了五重交叉验证策略,这个策略是用来评估模型的性能的方法,具体步骤:把我们一个大的数据集拆成5份,1份当成测试集,4份当成训练集。这样进行评估,然后重复五次取平均值来评估性能。这里只取了一部分,剩下的在extended图里。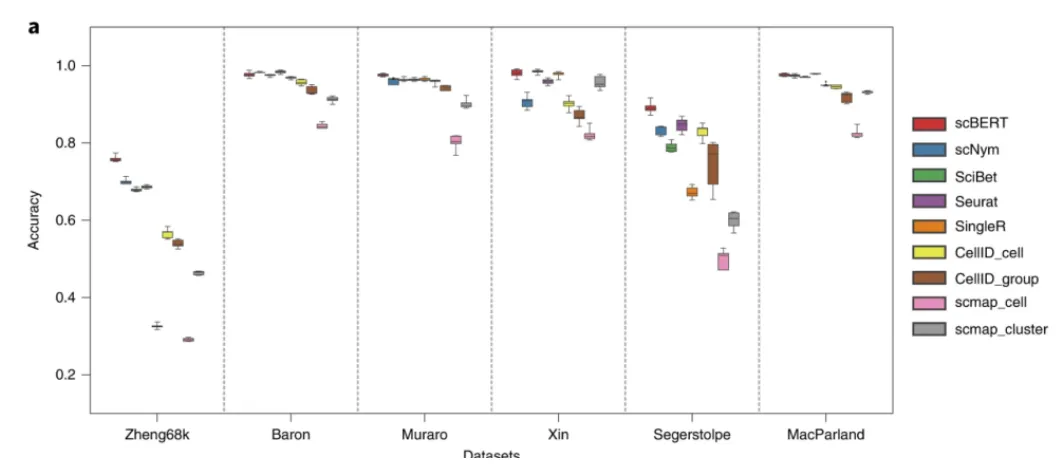
模型注释能力:其中Zheng68K是最具代表性的细胞类型注释方法数据集,其特点就是细胞类型失衡严重、不同细胞亚型之间相似度很高,用SOTA方法也达不到0.71以上的精度。而使用scBERT的话,即使完全不用已经报道过的marker基因,能够实现的性能也和其他方法相当,而加入marker基因可以进一步增加准确率。在整个细胞的层面上,极大的超过了SOTA方法,并且实现了CD8+ cytotoxic T cells 和 CD8+/CD45RA+ T cells这两种细胞的分类的最优结果。根据不同的任务和不同的数据,最优的方法往往是不同的,但是scBERT总是能出现在前几名,这也体现了在多样的数据集上的通用性。后面又测试了拆分不同比例的数据集作为参考数据集对scBERT的影响,可以看到随着比例越大,其性能越强(如图)。而且测试了对一个数据集中细胞数目分布不平衡的情况,选择了4种细胞在不平衡的情况下进行测试,这4种细胞之间存在较强的相似性,而scBERT表现良好。
SOTA:State-Of-The-Art,表示在当前领域最好的模型,其实就是benchmark的时候跑分非常高的模型。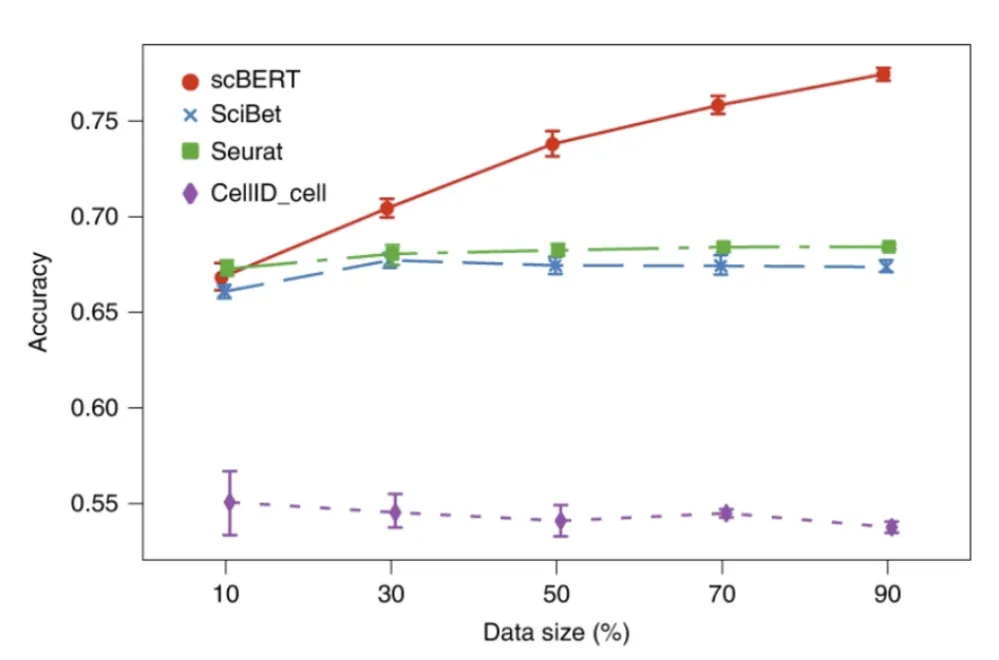
消除批次效应:做了这样的测试之后,又测试了跨越多个研究的数据集造成的批次效应对scBERT性能的影响,用了一系列不同测序技术产生的数据。机器学习方法取得了很大的成功,其中Seurat这个方法依赖投喂前的强制性数据矫正。scBERT基本没出错,且识别不同测序技术、不同实验、不同状态的细胞的时候很准确。
发现新细胞类型:很多技术都是针对与给出的细胞类型进行分类,而这些机器学习模型可能会根据数据中的细小的差异来预测是否有新的细胞类型产生,而且scBERT的多头注意力(来自transformer架构)可以提取潜在信息;而且scBERT可能已经看到了新的细胞类型,并在数据集上通过预训练了解了他们的基因表达模式;Transformer联系上下文的能力非常强,因为没有decoder这个部分,所以没有mask,也就是可以将所有基因纳入感受野(这里为了扩大基因数量用了performer,前文有提到),综合所有基因识别细胞类型。在这之后进行评估,其他模型相比scBERT而言相对较差。
可解释性:机器学习方法一般都是要高可变基因,或利用降维的方法,这样的话破坏了基因水平的可解释性。降维的方法让维度变换,即使是前后维度不变,最终经过降维步骤也是会导致难以进行解释。在进行可解释性的检查时候,首先他们利用Muraro数据集为4种胰岛细胞制定了顶级注意力列表,这4种细胞被充分研究过,其生物学功能很清晰。这个顶级注意力表中包括了特定细胞类型的标记物(某些细胞特异性表达的蛋白)和经过DESeq标记为差异表达基因的多个基因作为潜在新型标记物。在这个表中几乎所有基因都能找到其细胞特异性的功能。对前50个基因进行富集,结果表明富集出来的基因和细胞类型密切相关,而且富集最厉害的几个基因的功能对细胞来说极为重要。这也说明可以利用模型的可解释性做下游的功能分析。
模型的局限:优点就先不提了,总结来说就是:预测的鲁棒性好、面对批次效应影响也比较小、通用性强、能发现新细胞类型等等。但是也有一定的局限:基因表达嵌入的时候因为需要离散变量,但是我们只能提供连续变量,虽然通过scBERT能转化为离散变量,但是也牺牲了一部分数据的分辨率;同时因为我们的基因表达调控是以网络形式实现的,这样的先验知识没有设置进入scBERT里面,想办法用transformer for graph是重要的;预训练的时候进行遮蔽的时候遮蔽效率也值得优化,当前对于非零遮蔽,因为单细胞数据的基因表达很多都是0,也就是在整个过程中会得到很多的0,为了防止最后预测出来都是0,所以他们只对非0值做了遮蔽,这一定程度上也影响了训练,所以后续可能还需要更多的策略针对0值。
整体看下来这个模型比较简单,通读下来加上理解只用了两天的空闲时间,但是这个模型的意义还是比较深远的,这个模型将scRNA-seq数据作为输入学习了特征并对细胞进行注释,可以说是起了个好头。后面可能还在准备读scGPT这几篇。